Essa é uma dúvida muito mais comum do que parece.
Em muitos cenários, o verdadeiro impacto está nas decisões tomadas durante a modelagem física do banco de dados. E quando falamos de modelagem, não estamos nos referindo apenas à criação de tabelas, relacionamentos ou índices. Pequenas escolhas, muitas vezes feitas de forma automática ou sem uma análise mais aprofundada, podem gerar um impacto significativo no armazenamento ao longo do tempo.
A proposta deste artigo é comparar duas tabelas com exatamente a mesma estrutura, a mesma quantidade de registros e os mesmos dados armazenados. A única diferença entre elas estava no conjunto de caracteres (Character Set e Collation) utilizado.
De um lado, uma tabela configurada com LATIN1.
Do outro, uma tabela configurada com UTF8MB4, padrão adotado pelas versões mais recentes do MySQL e recomendado para aplicações modernas.
Ambas receberam a mesma carga de dados e passaram pelos mesmos processos de armazenamento.
O resultado mostrou que, mesmo contendo exatamente as mesmas informações, houve diferença no espaço ocupado em disco.
À primeira vista, a variação pode parecer pequena. Porém, quando projetamos esse comportamento para ambientes corporativos contendo centenas de milhões ou até bilhões de registros, alguns bytes adicionais por linha podem representar gigabytes ou até dezenas de gigabytes extras de armazenamento.
E o impacto não para por aí.
Mais espaço consumido significa índices maiores, mais páginas de dados para leitura, backups mais extensos, maior tempo de restauração e potencial aumento no consumo de memória durante operações de consulta.
Isso não significa que UTF8MB4 seja uma escolha errada. Muito pelo contrário. Ele oferece suporte completo a múltiplos idiomas, símbolos especiais e emojis, sendo a opção mais adequada para a maioria dos sistemas modernos.
A grande reflexão é outra:
Você realmente conhece o impacto das escolhas feitas durante a modelagem do seu banco de dados?
Porque, muitas vezes, o crescimento que parece ser causado pela volumetria é apenas o reflexo de decisões técnicas tomadas lá no início do projeto.
E como costumo dizer em sala de aula:
“A quantidade de dados faz seu banco crescer. Mas são as escolhas de modelagem que definem o quanto ele vai crescer.”
SOBRE O CENÁRIO:
Após criar o banco e as respectivas tabelas, é hora do teste de volumetria para o laboratório contido neste artigo, inseri 450.000.000 (milhões) de linhas e obtiveram tempos bem distintos para a sua conclusão.
Configuração da Máquina Utilizada:
Processador: I5-7200U 2.50GHz 2.70GHz
Memória RAM: 32 GB
Armazenamento: NVME 1B
Sistema Opercaional: Windows 10 22H2
Versão do MySQL: 5.7
TABELAS CRIADAS
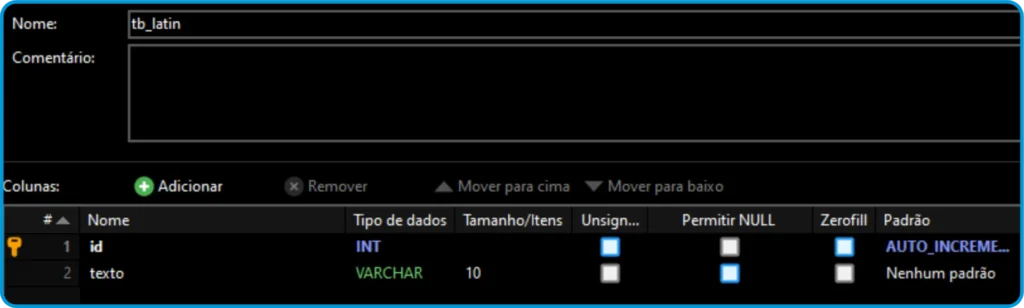
Foram criadas 2 tabelas com as mesmas estruturas, o que o diferenciam é apenas a collation dos atributos. A imagem abaixo demonstra a estrutura básica de ambas as tabelas.
Tempos de execução:
|
|
Latin1 |
Utf8mb4 |
|
Quantidade de registros: |
450.000.000 |
450.000.000 |
|
Duração: |
02:27:56 |
01:53:08 |
Portanto, um tempo bem considerável. Caso queria reproduzir entenda que demorará um pouco até a finalização.
DDL para criar o banco de dados para testes:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
DROP DATABASE IF EXISTS `db_comunidade_mysql`; CREATE DATABASE IF NOT EXISTS `db_comunidade_mysql` /*!40100 DEFAULT CHARACTER SET latin1 COLLATE latin1_general_ci */ /*!80016 DEFAULT ENCRYPTION='N' */; USE `db_comunidade_mysql`; DROP TABLE IF EXISTS `tb_latin`; CREATE TABLE IF NOT EXISTS `tb_latin` ( `id` int NOT NULL AUTO_INCREMENT, `texto` varchar(10) CHARACTER SET latin1 COLLATE latin1_general_ci NOT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=450028846 DEFAULT CHARSET=latin1 COLLATE=latin1_general_ci; DROP TABLE IF EXISTS `tb_utf8mb4`; CREATE TABLE IF NOT EXISTS `tb_utf8mb4` ( `id` int NOT NULL AUTO_INCREMENT, `texto` varchar(10) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci NOT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB AUTO_INCREMENT=450028846 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci; |
DML para inserçãod e dados nas tabelas:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 |
-- Query para inserção 450.000.000 registros na tabela tb_latin: INSERT INTO tb_latin(texto) SELECT nomes.texto FROM information_schema.columns c1 CROSS JOIN information_schema.columns c2 CROSS JOIN information_schema.columns c3 CROSS JOIN ( SELECT 'João' AS texto UNION ALL SELECT 'Maria' ) nomes LIMIT 450000000; -- Query para inserção 450.000.000 registros na tabela tb_utf8mb4: INSERT INTO tb_utf8mb4 (texto) SELECT nomes.texto FROM information_schema.columns c1 CROSS JOIN information_schema.columns c2 CROSS JOIN information_schema.columns c3 CROSS JOIN ( SELECT 'João' AS texto UNION ALL SELECT 'Maria' ) nomes LIMIT 450000000; |
Query para verificação dos tamanhos das respectivas tabelas
|
1 2 3 4 5 6 7 8 |
SELECT TABLE_NAME, ROUND(DATA_LENGTH / 1024 / 1024 / 1024, 2) AS DATA_GB, ROUND(INDEX_LENGTH / 1024 / 1024 / 1024, 2) AS INDEX_GB, ROUND((DATA_LENGTH + INDEX_LENGTH) / 1024 / 1024 / 1024, 2) AS TOTAL_GB FROM information_schema.TABLES WHERE TABLE_SCHEMA = 'db_comunidade_mysql' AND TABLE_NAME IN ('tb_latin', 'tb_utf8mb4'); |
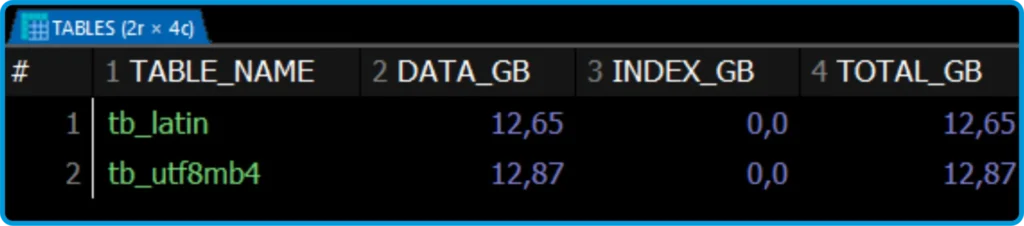
O resultado foi uma diferença pequena, mas houve.
Ressalvo que os registros inseridos só continham no campo texto os valores João e Maria.
🔎 O impacto da escolha do tipo de collation no armazenamento
Mesmo armazenando exatamente a mesma quantidade de registros (450 milhões de linhas) e praticamente os mesmos dados de negócio, o tipo de escolhida apresentou pequena diferença no consumo de espaço.
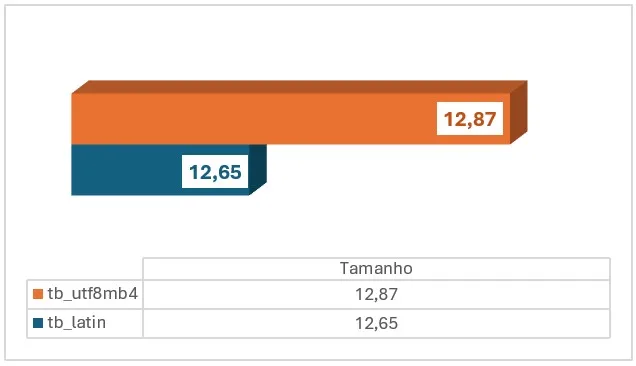
A tabela utilizando latin consumiu aproximadamente 12,65 GB, enquanto a versão com utf8mb4 chegou a 12,87 GB, representando um aumento discreto de cerca de 1,74%. Em cenários onde existe a possibilidade real de ultrapassar o limite do INT, esse crescimento costuma ser aceitável.
Perceba que na imagem existem uma diferença entre as quantidades de registros existentes nas tabela, algo que chega a mais de 1.958.252 registros, mas é apenas uma estimativa. Ambas contam exatamente com 450.000.000.
O motivo
No InnoDB, a coluna TABLE_ROWS da tabela information_schema.tables não é exata.
A própria documentação da MySQL informa que para tabelas InnoDB esse valor é uma estimativa baseada em estatísticas internas.
Conclusão
Ao longo deste experimento, ficou evidente que o crescimento de um banco de dados nem sempre está diretamente relacionado à quantidade de registros armazenados. Em muitos casos, decisões tomadas durante a modelagem física, como a escolha do conjunto de caracteres e da collation, podem influenciar significativamente o consumo de espaço ao longo do tempo.
Mesmo trabalhando com uma volumetria expressiva de 450 milhões de registros, a diferença observada entre as tabelas utilizando LATIN1 e UTF8MB4 foi de aproximadamente 1,74%, representando um acréscimo de apenas 0,22 GB no armazenamento total. Embora exista um impacto mensurável, os resultados demonstram que, para este cenário específico, o custo adicional do UTF8MB4 foi relativamente pequeno quando comparado aos benefícios oferecidos por esse conjunto de caracteres.
Vale destacar também que os valores apresentados na coluna TABLE_ROWS do InnoDB são apenas estimativas estatísticas utilizadas pelo mecanismo de armazenamento. Apesar da diferença exibida nessa métrica, ambas as tabelas possuem exatamente 450.000.000 de registros, garantindo que a comparação tenha sido realizada sob as mesmas condições.
Mais do que identificar qual opção ocupa menos espaço, o principal objetivo deste estudo foi demonstrar a importância de compreender os impactos técnicos das escolhas realizadas durante o projeto de um banco de dados. Em ambientes corporativos, onde volumes massivos de informação são armazenados diariamente, pequenas diferenças por registro podem se transformar em gigabytes adicionais ao longo dos anos.
A grande lição é que a otimização de armazenamento não deve ser baseada em suposições, mas em evidências. Antes de adotar uma estratégia apenas por tradição ou preferência, vale a pena medir, comparar e entender os reais impactos envolvidos.
Porque, no final das contas, bancos de dados não crescem apenas pela quantidade de informações armazenadas. Eles crescem, principalmente, pelas decisões que tomamos durante sua construção.
Modelagem bem-feita não é detalhe. É engenharia.
Esperem que curtam e até o próximo artigo.