Minha volumetria não é tão intensa para justificar esse crescimento.
Essa é uma dúvida muito mais comum do que parece.
Quando um banco de dados começa a crescer além do esperado, a primeira reação costuma ser culpar a quantidade de registros armazenados. Porém, em muitos cenários, o verdadeiro problema não está na quantidade de dados, mas sim nas decisões tomadas durante a modelagem.
Recentemente, durante um workshop sobre modelagem de dados e otimização de armazenamento, realizei um experimento simples, porém extremamente esclarecedor.
Foram criadas três tabelas idênticas, contendo apenas dois campos:
- ID
- TEXTO (VARCHAR(1))
Como mostra a imagem abaixo:
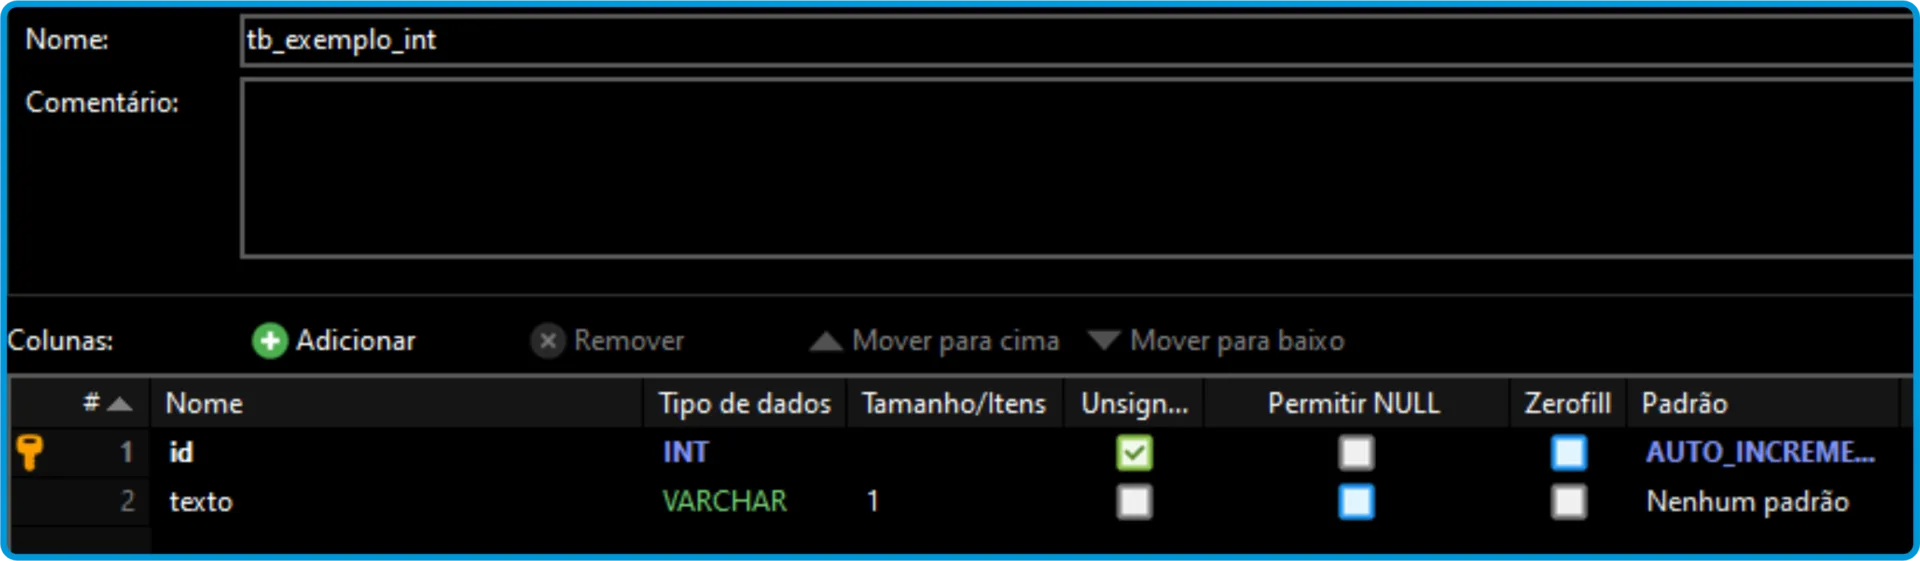
A única diferença entre elas estava no tipo de dado utilizado para o campo ID:
- tb_exemplo_int : ID INT
- tb_exemplo_bigint: ID BIGINT
- tb_exmplo_uuid : ID BINARY(16)
Após criar o banco e as respectivas tabelas, é hora do teste de volumetria para o laboratório contido neste artigo, inseri 450.000.000 (milhões) de linhas, estimativa de duração de aproximadamente 01:51:45 em uma máquina com a seguinte configuração:
Processador: I5-7200U 2.50GHz 2.70GHz
Memória RAM: 32 GB
Armazenamento: NVME 1B
Sistema Opercaional: Windows 10 22H2
Versão do MySQL: 5.7
Portanto, um tempo bem considerável. Caso queria reproduzir entenda que demorará um pouco até a finalização.
DDL para criar o banco de dados para testes:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 |
DROP DATABASE IF EXISTS `db_artigo_mysql`; CREATE DATABASE IF NOT EXISTS `db_artigo_mysql` /*!40100 DEFAULT CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci */ /*!80016 DEFAULT ENCRYPTION='N' */; USE `db_artigo_mysql`; DROP TABLE IF EXISTS `tb_exemplo_int`; CREATE TABLE IF NOT EXISTS `tb_exemplo_int` ( `id` int unsigned NOT NULL AUTO_INCREMENT, `texto` varchar(1) NOT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci; DROP TABLE IF EXISTS `tb_exemplo_bigint`; CREATE TABLE IF NOT EXISTS `tb_exemplo_bigint` ( `id` bigint unsigned NOT NULL AUTO_INCREMENT, `texto` varchar(1) CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci NOT NULL, PRIMARY KEY (`id`) USING BTREE ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci ROW_FORMAT=DYNAMIC; DROP TABLE IF EXISTS `tb_exemplo_uuid`; CREATE TABLE IF NOT EXISTS `tb_exemplo_uuid` ( `id` binary(16) NOT NULL DEFAULT (uuid_to_bin(uuid())), `texto` varchar(1) DEFAULT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_0900_ai_ci; |
DML para inserção dos dados nas tabelas:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 |
-- Query inserção 450.000.000 de linhas na tabela tb_exemplo_int: INSERT INTO tb_exemplo_int(texto) SELECT 'B' FROM information_schema.columns c1 CROSS JOIN information_schema.columns c2 CROSS JOIN information_schema.columns c3 LIMIT 450000000; -- Query inserção 450.000.000 de linhas na tabela tb_exemplo_bigint: INSERT INTO tb_exemplo_bigint(texto) SELECT 'B' FROM information_schema.columns c1 CROSS JOIN information_schema.columns c2 CROSS JOIN information_schema.columns c3 LIMIT 450000000; -- Query para inserção 450.000.000 registros na tabela tb_exemplo_uuid: INSERT INTO tb_exemplo_uuid (texto) SELECT 'U' FROM information_schema.columns c1 CROSS JOIN information_schema.columns c2 CROSS JOIN information_schema.columns c3 LIMIT 450000000; |
Query para verificação do tamanhos das tabelas após inserção:
|
1 2 3 4 5 6 7 8 9 |
SELECT table_name, table_rows, ROUND(data_length / 1024 / 1024/ 1024, 2) AS data_gb, ROUND(index_length / 1024 / 1024/ 1024, 2) AS index_mb, ROUND(data_free / 1024 / 1024/ 1024, 2) AS free_mb FROM information_schema.tables WHERE table_schema = 'db_artigo_mysql' AND table_name in ('tb_exemplo_int', 'tb_exemplo_bigint', 'tb_exemplo_uuid'); |
As 3 tabelas têm a mesma estrutura, o que os diferencia é apenas o nome de cada uma e o tipo de dados do campo ID.
O resultado foi surpreendente.
🔎 O impacto da escolha do tipo de chave primária no armazenamento
Mesmo armazenando exatamente a mesma quantidade de registros (450 milhões de linhas) e praticamente os mesmos dados de negócio, o tipo de dado escolhido para a chave primária provocou diferenças significativas no consumo de espaço.
A tabela utilizando INT consumiu aproximadamente 12,7 GiB, enquanto a versão com BIGINT chegou a 12,9 GiB, representando um aumento discreto de cerca de 1,6%. Em cenários onde existe a possibilidade real de ultrapassar o limite do INT, esse crescimento costuma ser aceitável.
Por outro lado, a tabela baseada em UUID apresentou um comportamento completamente diferente, atingindo 29,1 GiB. Isso representa um aumento de aproximadamente 129% em relação ao INT e cerca de 126% em relação ao BIGINT. Como mostra a imagem abaixo:
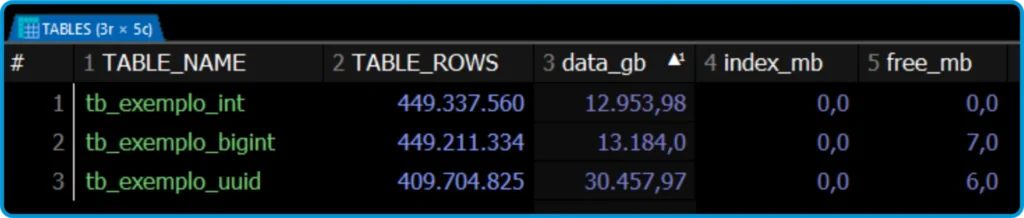
Perceba que na imagem existem uma diferença entre as quantidades de registros existentes nas tabela, algo que chega a mais de 1 milhão de registros, mas é apenas uma estimativa. Ambas contam exatamente com 450.000.000.
O motivo
No InnoDB, a coluna TABLE_ROWS da tabela information_schema.tables não é exata.
A própria documentação da MySQL informa que para tabelas InnoDB esse valor é uma estimativa baseada em estatísticas internas.
Percebam que a tabela com UUID ocupou mais que o dobro do espaço necessário para armazenar os mesmos 450 milhões de registros.
Agora imagine esse impacto não apenas em uma tabela, mas em todo um ambiente corporativo. O campo de identificação normalmente participa de:
- Índices primários;
- Índices secundários;
- Chaves estrangeiras;
- Tabelas de relacionamento;
- Estruturas internas do mecanismo de armazenamento.
Quando a chave é maior, todos esses componentes também crescem proporcionalmente.
O resultado pode ser:
- Maior consumo de armazenamento;
- Índices significativamente maiores;
- Mais páginas de dados para leitura;
- Aumento do tempo de backup e restore;
- Maior utilização de memória (Buffer Pool);
- Possível degradação de desempenho em consultas e joins.
Em muitos sistemas corporativos, um simples INT UNSIGNED é capaz de armazenar até 4.294.967.295 registros, quantidade suficiente para a grande maioria das aplicações. Quando essa capacidade não é suficiente, o BIGINT costuma ser uma alternativa mais eficiente em termos de armazenamento e desempenho do que a adoção indiscriminada de UUIDs.
A lição é simples: a escolha do tipo de dado de uma chave primária deve considerar não apenas funcionalidade, mas também volumetria, crescimento futuro e impacto operacional no banco de dados. Uma decisão tomada no início do projeto pode representar dezenas ou até centenas de gigabytes economizados ao longo da vida útil da aplicação.
Resumo dos testes (450 milhões de registros):
|
Tipo da Chave |
Tamanho |
|
INT |
12,7 GiB |
|
BIGINT |
12,9 GiB |
|
UUID |
29,1 GiB |
O UUID consumiu aproximadamente 16,4 GiB a mais que o INT, evidenciando como a modelagem física influencia diretamente no custo de armazenamento e na eficiência do banco de dados.
A lição é simples:
Modelagem de dados não é apenas desenhar tabelas e relacionamentos.
Modelagem é uma decisão estratégica que impacta diretamente:
✔ Espaço em disco
✔ Performance das consultas
✔ Tempo de backup e restore
✔ Consumo de memória
✔ Escalabilidade da solução
✔ Custos de infraestrutura
Antes de escolher um tipo de dado, pergunte-se:
“Eu realmente preciso de tudo isso?”
Porque, muitas vezes, uma pequena escolha feita hoje pode custar gigabytes ou até terabytes amanhã.
Modelagem bem-feita não é detalhe. É engenharia.