Falaa Galera.
Dando continuidade no post anterior “Como Ler um Explain” quero compartilhar como decido se um índice será “bom” ou “ruim” no MySQL, obviamente que irei demonstrar boas práticas.
A ideia aqui não são teorias, e sim o que funciona no dia a dia quando você tem milhões de linhas 😅😅😅.
🎯 O problema clássico
Ao analisarmos diversas consultas dia a dia, acredito que vocês ja passaram por isto:
- “Criei um índice e o MySQL não usou.”
- “O índice tem cardinalidade baixa, então é ruim?”
- “Esse índice é RUIM pela métrica, mas meu
EXPLAINmelhorou muito… como assim?”
🧪 O ambiente de testes
Para quem ja utilizou do Sysbench alguma vez já esbarrou na famosa tabela SBTEST1. Uma tabela simples mas essencial para demonstração, pois contém dados que confundem o otimizador.
- MySQL 8.x
- InnoDB
- Tabelas com centenas de milhões / bilhões de linhas
- Dados com distribuição real (skew, repetições, hot keys)
Estrutura tabela.
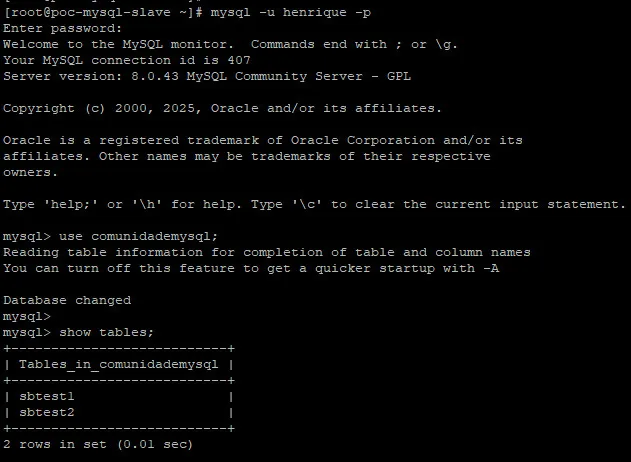
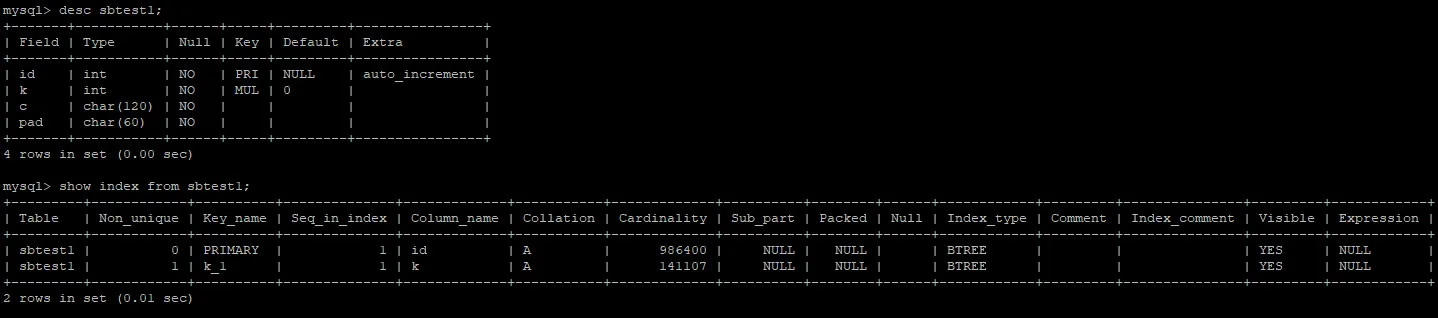
Vemos que, existem apenas 2 indices (por padrão desta tabela) temos a chave PRIMARY (id) e KEY ‘k‘.
Coluna “c” e “pad” não são indexadas. Algo intencional criado pelo SysBench.
🧠 Dois conceitos que o MySQL usa (e muita gente mistura)
Cardinalidade
No MySQL, refere-se apenas aos valores exclusivos (distintos) presentes naquela coluna.
Sendo assim, utilizo este comando abaixo para ter uma noção estatística da distribuição da coluna.
|
1 |
SELECT COUNT(DISTINCT columnName) / COUNT(*) AS seletividade FROM tableName; |
Demostrando na prática.
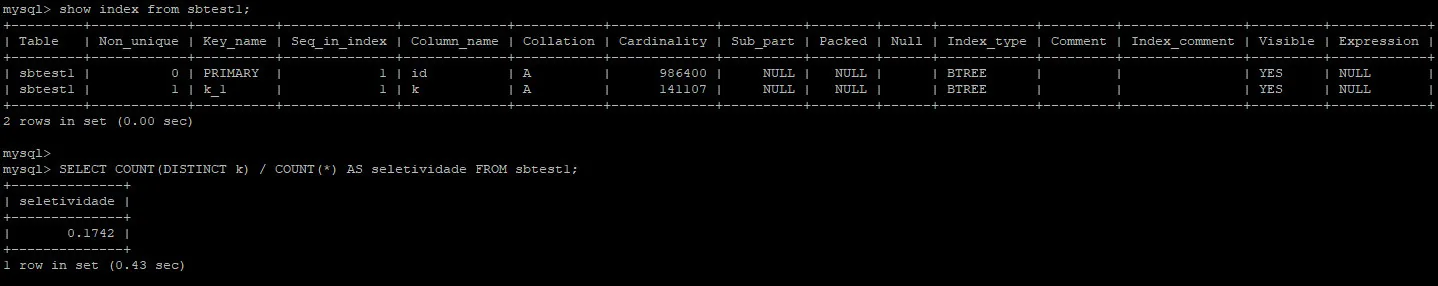
- Isto é o que o otimizador “MySQL” esta estimando.
- Podemos estar desatualizados (necessitando um ANALYZE TABLE).
Agora, os 2 comandos que considero importantes para as validações de colunas é:
|
1 2 3 4 5 |
SELECT COUNT(*) AS total_linhas, COUNT(DISTINCT columnNAME) AS valores_distintos, ROUND(COUNT(*) / COUNT(DISTINCT columnNAME), 2) AS linhas_por_valor FROM sbtest1; |
|
1 |
SELECT COUNT(*) / COUNT(DISTINCT columName) AS linhas_por_valor FROM sbtest1; |
Na prática:
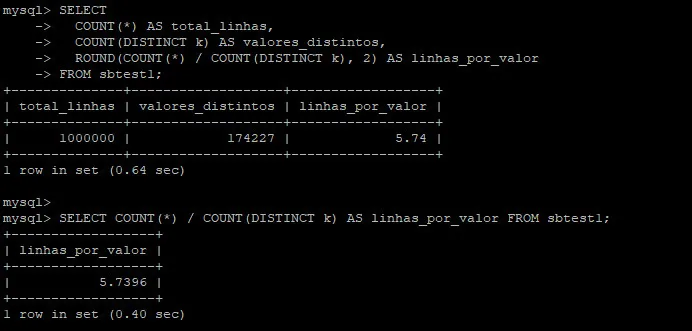
Retornando, em média quantas linhas cada valor estará retornando.
Essa métrica, verifica diretamente com o ROWS do EXPLAIN.
E também utilizo bastante esta regra abaixo, que com o tempo fui acompanhando.
| Linhas por valor | Avaliação prática |
| < 100 | ⭐ índice excelente |
| 100 – 5.000 | ✅ índice bom |
| 5.000 – 50.000 | ⚠️ índice médio |
| > 50.000 | ❌ índice ruim |
🔎 Analisando os índices reais: Sbtest1
O primeiro, coluna ID (o indice perfeito).
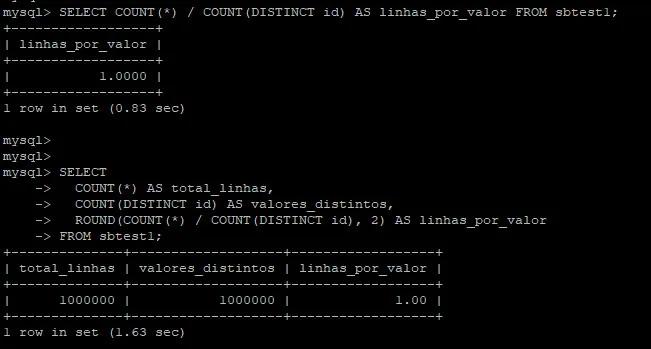
- PRIMARY KEY
- Lookup direto
- 1 Linha.
✅ Nenhuma discussão aqui.
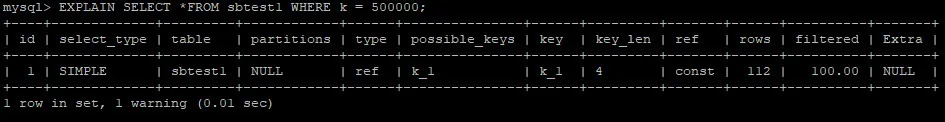
Coluna K, o índice que parece ruim, mas funciona.
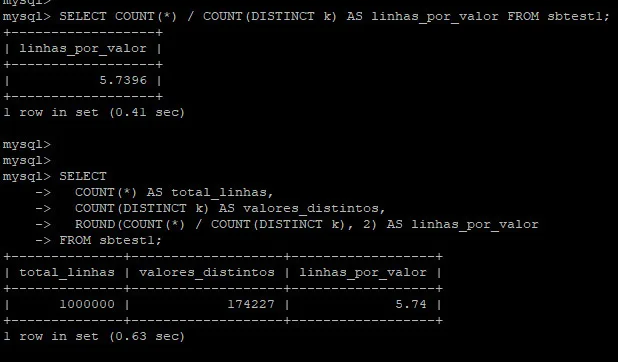
Agora, o plano de execução:
❌ O erro clássico: tentar indexar tudo.
Olhando para a coluna PAD, vemos uma alta variação de informações nela.
Sendo assim, o DBA pensa:
“Tem alta variabilidade, vou criar índice”.
Então:
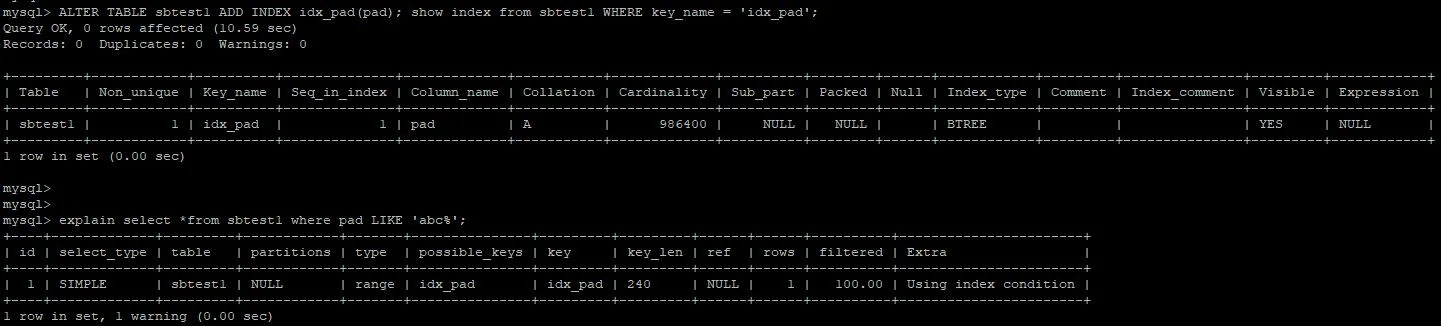
type: rangekey: idx_padrows: 1Using index condition
✅ Índice usado
✅ Poucas linhas
✅ Plano “bonito”
⚠️ Por que esse índice engana
O indice não é ruim tecnicamente –> Ele apenas funiciona.
O problema é o tipo de consulta que está sendo usada para justificá-lo.
|
1 |
WHERE pad LIKE 'abc%'; |
Esse padrão:
- ✅ usa prefixo
- ✅ permite range scan no B‑Tree
- ✅ favorece o índice
Ou seja: você escolheu a melhor query possível para o índice parecer bom.
🧠 Agora a pergunta que importa
“Essa é a query que realmente roda em produção?”
Porque basta trocarmos o operador para:
|
1 |
WHERE pad LIKE '%abc%'; |
e o cenário muda completamente:
- ❌ índice não pode ser usado
- ❌ full scan inevitável
- ❌ custo de escrita mantido
- ❌ índice vira peso morto
No MySQL, cardinalidade refere‑se à quantidade estimada de valores distintos em uma coluna. Esse número é utilizado pelo otimizador como heurística, não como verdade absoluta.
Referências.
https://dev.mysql.com/doc/refman/8.0/en/mysql-indexes.html
https://www.mysqltutorial.org/mysql-index/mysql-index-cardinality/
https://planetscale.com/learn/courses/mysql-for-developers/indexes/index-selectivity
https://dev.mysql.com/doc/refman/8.0/en/index-btree-hash.html